HADOOP起源,发展。
Nutch(2002年8 月)一个开源的Java搜索引擎框架,设计目标是构建一个大型的全网搜索引擎,包括网页抓取、索引、查询等功能,但随着抓取网页数量的增加,遇到了严重的可扩展性问题——如何解决数十亿网页的存储和索引问题。 2003年开始谷歌陆续发表的三篇论文为该问题提供了可行的解决方案。
- 分布式文件系统(Google File System, GFS): 可用于处理海量网页的存储。
- 分布式计算框架MapReduce: 可用于处理海量网页的索引计算问题。
- BigTable 数据库:可以在超大数据集中进行实时CRUD操作的功能。
Nutch开发人员完成了相应的开源,实现HDFS和MapReduce,并从Nutch中剥离成为独立项目 HADOOP。 2008年1月,HADOOP成为Apache顶级项目。
- Hadoop1.x:HDFS + MapReduce(MR同时做计算+资源调度,耦合严重)
- Hadoop2.x:引入 YARN,把资源调度拆出来;MapReduce 只做计算编程模型,YARN 作为统一资源管理器
- Hadoop3.x:优化 HDFS 高可用、纠删码存储、支持更多调度、容器化适配
Hadoop 与 JDK version
| Hadoop版本 | 最低要求 | JDK官方支持运行 | 推荐 |
|---|---|---|---|
| 1.x/ 2.6.x 及更早 | JDK6 | JDK6 | JDK6 |
| 2.7.x ~ 2.10.x | JDK7 | JDK7、JDK8 | JDK8 |
| 3.0.x ~ 3.2.x | JDK8 | JDK8 | JDK8 |
| 3.3.x(3.3.0~3.3.4) | JDK8 | JDK8、JDK11 | JDK11 |
| 3.3.5+ | JDK8 | JDK8、JDK11,JDK17有限支持 | JDK11 |
| 3.4.x | JDK8 | JDK8、JDK11、JDK17 | JDK11/JDK17 |
| 3.5.x 及以上 | JDK17 | Server 强制 JDK17;Client 可JDK17/JDK21 | JDK17 |
安装
shell
sudo apt-get install openjdk-17-jdk下载hadoop
- 官网地址:https://hadoop.apache.org/releases.html
- 清华镜像源:https://mirrors.tuna.tsinghua.edu.cn/apache/hadoop/core/ 选择二进制文件 解压 sudo tar -xzvf hadoop-3.5.0.tar.gz -C /usr/local/ 去掉版本号后缀 sudo mv hadoop-3.5.0 hadoop 赋予权限 sudo chown -R [username] ./hadoop 配置 ~/.bashrc 文件:
shell
export JAVA_HOME=/usr/lib/jvm/jdk/openjdk-17-jdk-amd64
export HADOOP_HOME=/usr/local/hadoop
export PATH=${JAVA_HOME}/bin:${HADOOP_HOME}/bin:$PATH安装 SSH:
shell
sudo apt-get install openssh-server配置SSH免密连接
hadoop服务启动会使用到 ssh服务
shell
ssh-keygen -t rsa
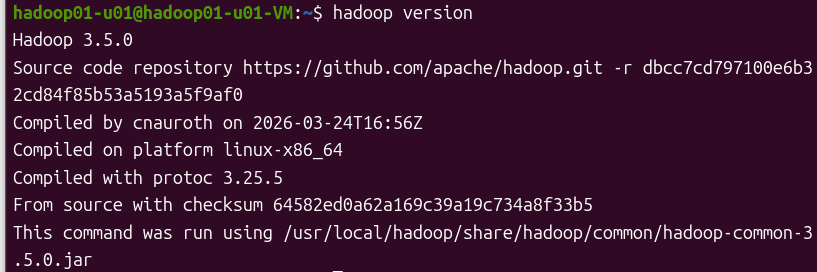
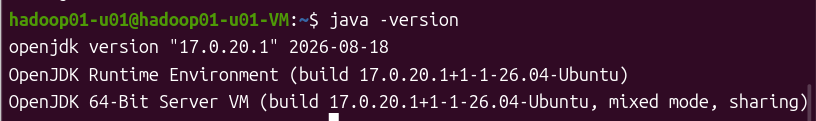
cd .ssh && cat ./id_rsa.pub >> ./authorized_keys验证安装是否成功
Hadoop伪分布式配置(在单个节点中运行Hadoop)
修改配置文件 /usr/local/hadoop/etc/hadoop/core-site.xml
xml
<configuration>
  <property>
    <name>hadoop.tmp.dir</name>
    <value>file:/usr/local/hadoop/tmp</value>
    <description></description>
  </property>
  <property>
    <name>fs.defaultFS</name>
    <value>hdfs://localhost:9000</value>
  </property>
</configuration>修改配置文件 /usr/local/hadoop/etc/hadoop/hdfs-site.xml
xml
<configuration>
  <property>
    <name>dfs.replication</name>
    <value>1</value>
  </property>
  <property>
    <name>dfs.namenode.name.dir</name>
    <value>file:/usr/local/hadoop/tmp/dfs/name</value>
  </property>
  <property>
    <name>dfs.datanode.data.dir</name>
    <value>file:/usr/local/hadoop/tmp/dfs/data</value>
  </property>
</configuration>namenode 格式化
shell
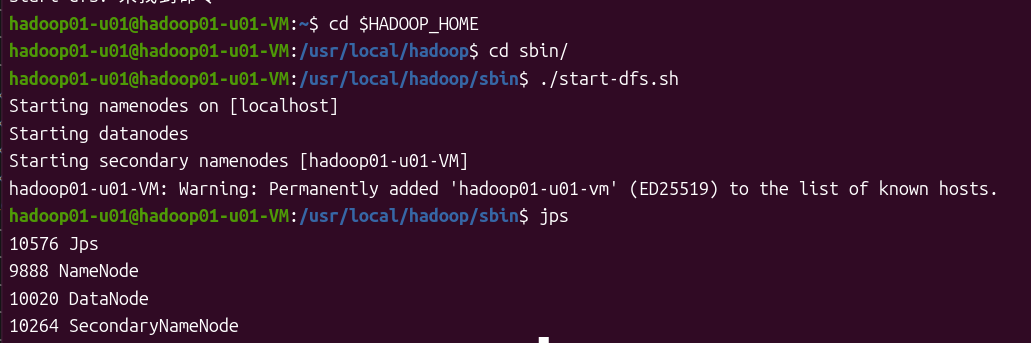
hdfs namenode -format启动hdfs 服务,在 $HADOOP_HOME/sbin 下执行 start-dfs.sh 或者执行 $HADOOP_HOME/sbin/start-dfs.sh
显示没有权限或者认证失败,需要ssh 免密连接,配置方式如下:
shell
ssh-keygen -t rsa
cd ~/.ssh && cat ./id_rsa.pub >> ./authorized_keys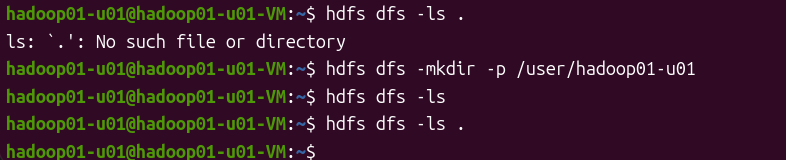
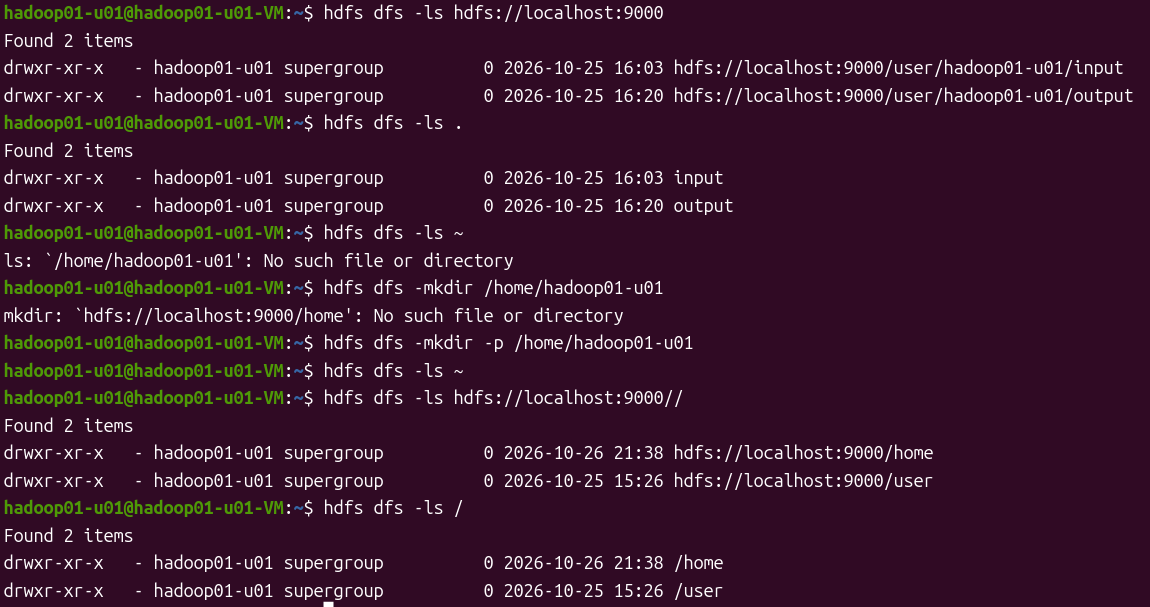
hadoop 相对路劲表示方法
- "." 表示 /user/[user_name]
- "~" 表示 /home/[user_name]
创建目录
shell
hdfs dfs -mkdir [path]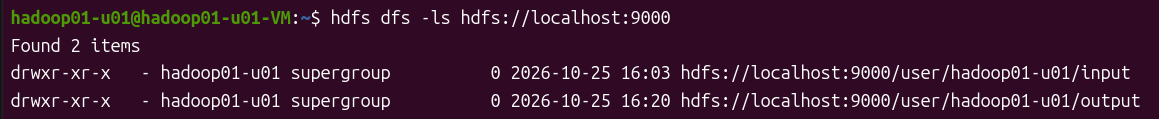
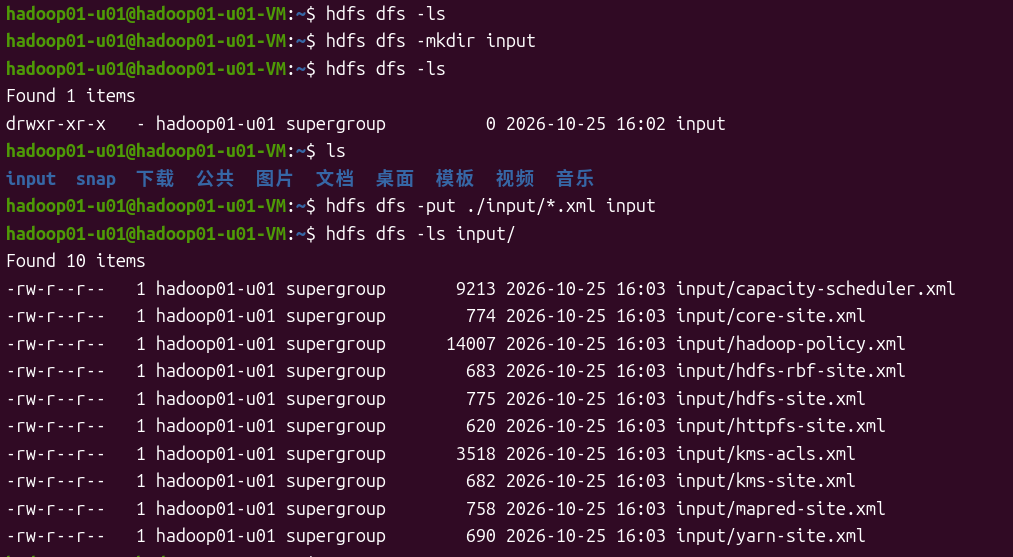
上传到HDFS中
shell
hdfs dfs -put [源文件或路径] target_url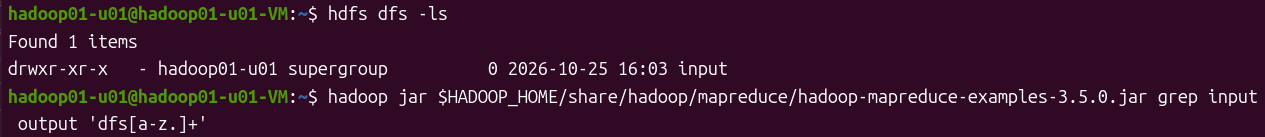
执行hadoop 查找
shell
hdfs dfs -ls [target_url]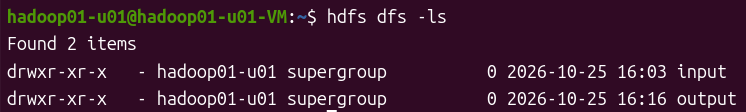
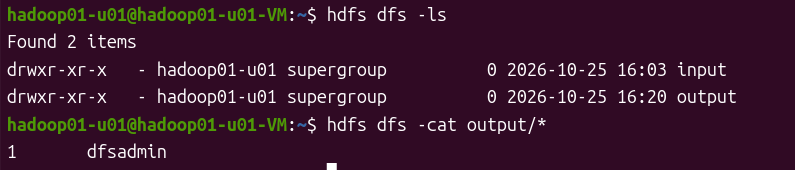
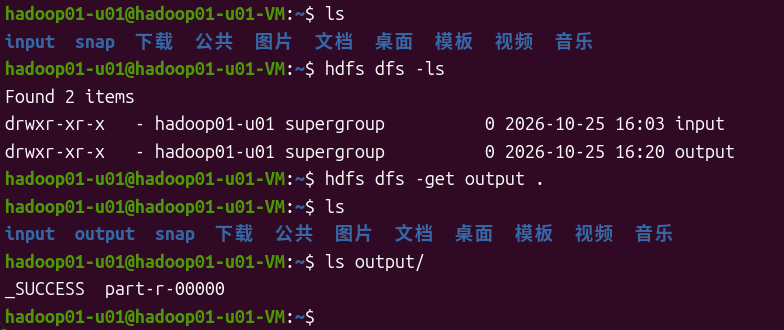
下载 HDFS系统中的文件
shell
hdfs dfs -get source_path target_url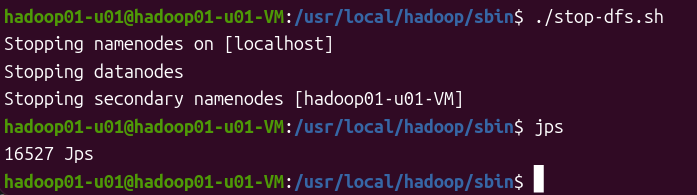
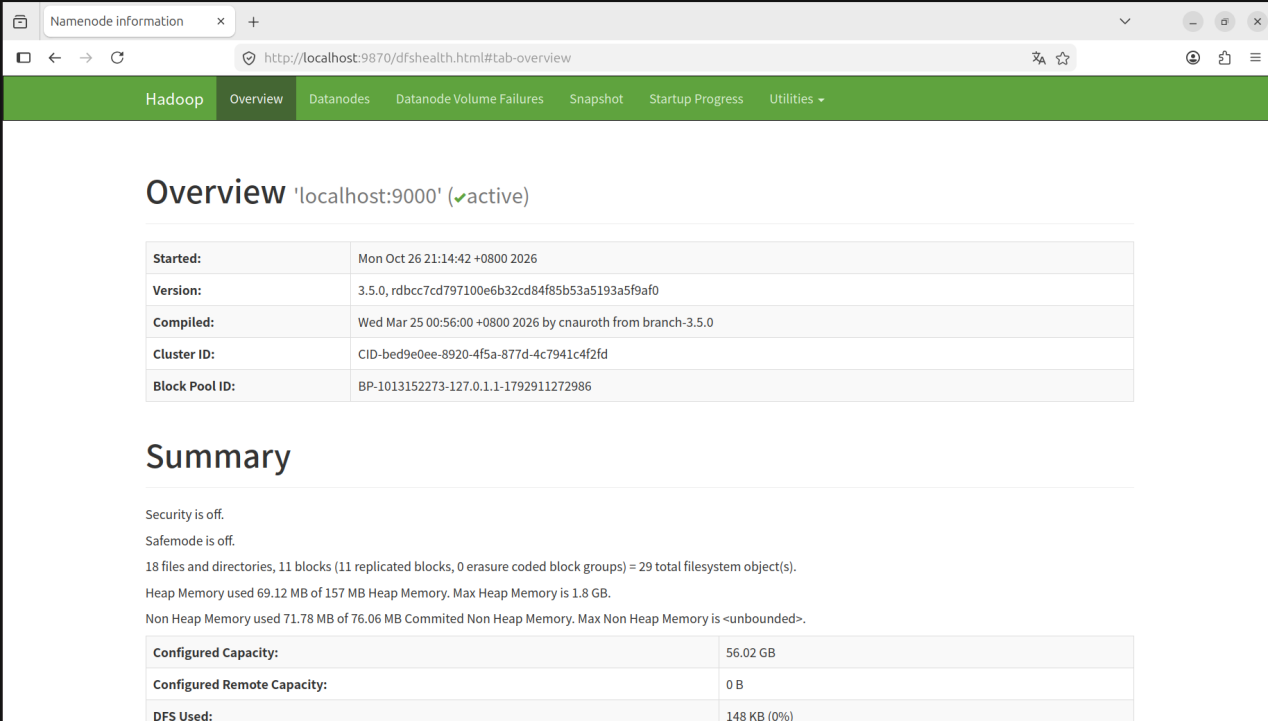
Web 访问
停止hdfs 服务
在 $HADOOP_HOME/sbin 下执行 stop-dfs.sh
shell
$HADOOP_HOME/sbin/stop-dfs.sh